Aprendizaje automático
Dennis Lenz

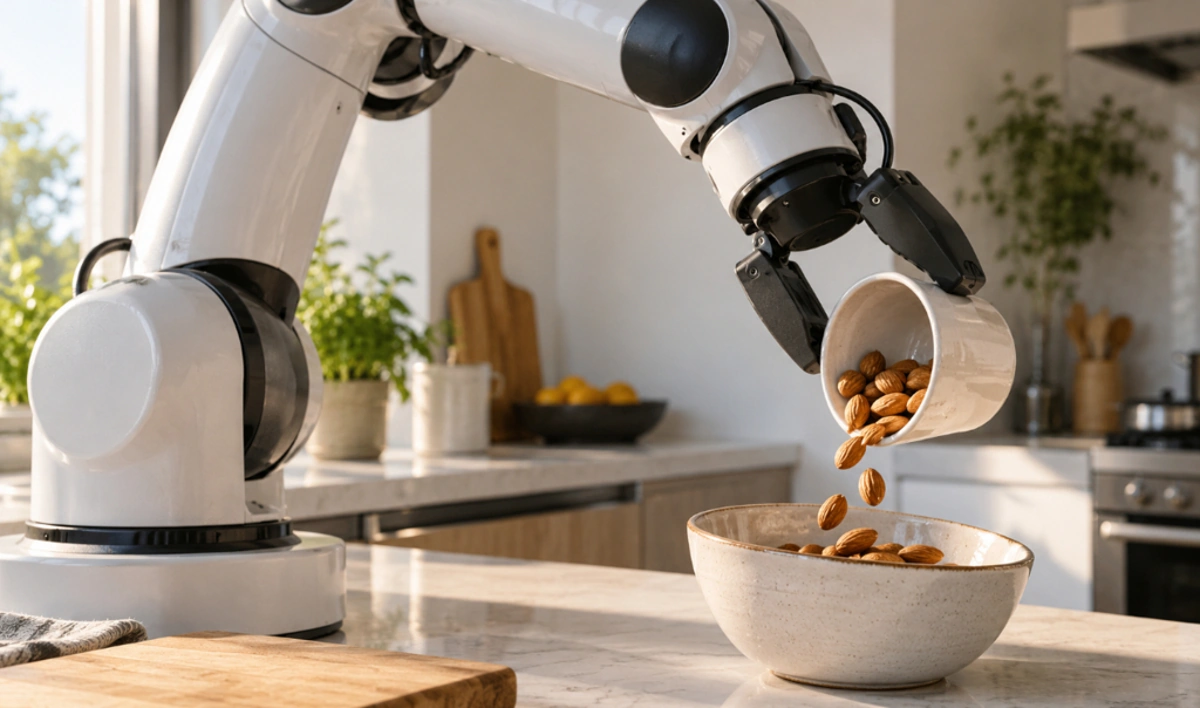
(Imagen simbólica). Los robots aprenden secuencias de movimientos a partir de vídeos, sin que sea necesario registrar cada movimiento de las articulaciones como una orden de la máquina en las grabaciones. Un nuevo modelo de IA se centra en las trayectorias espaciales de manos, herramientas y objetos. En las pruebas con un brazo robótico, el sistema logró una alta tasa de éxito promedio en tres tareas del mundo real. Sin embargo, todavía no está claro hasta qué punto se puede aplicar el método a tareas mucho más complejas y a otros tipos de robots.
(Foto: © Investigación y conocimiento, imagen de IA)
En los vídeos de formación, un brazo robótico no observa los ángulos de las articulaciones y no recibe ninguna orden de la máquina terminada. Sin embargo, puede aprender de él cómo mover una taza, cómo volcar un cuenco o cómo desplegar un paño. Los robots aprenden principalmente los movimientos espaciales de manos y objetos a través de vídeos utilizando un nuevo modelo de inteligencia artificial de la Universidad de Maryland. En experimentos reales, el enfoque logró una tasa de éxito promedio del 91,7% en tres tareas.
Una persona puede ver inmediatamente lo que sucede durante el movimiento diario. Una mano agarra un recipiente, lo levanta, lo voltea y deja caer el contenido en un recipiente. Para un robot, esto implica una larga cadena de decisiones espaciales. Debe reconocer qué objeto es relevante, dónde se mueve, cuánto se debe girar y en qué punto el contacto con un segundo objeto se vuelve crucial. Hasta ahora, muchas máquinas han aprendido estas tareas mediante demostraciones minuciosamente grabadas, en las que no sólo se guardan las imágenes de la cámara, sino también los estados exactos y los comandos de control del robot. Estos datos son caros y además están muy ligados a un robot específico. El nuevo sistema llamado μ₀ intenta evitar exactamente este problema. El modelo primero debería aprender de las grabaciones normales qué necesita moverse antes de que un segundo componente lo utilice para generar comandos concretos para un robot específico.
El procedimiento forma parte de la investigación sobre la llamada inteligencia física. Se trata de sistemas de inteligencia artificial que no sólo utilizan el lenguaje y la percepción visual para respuestas digitales, sino que también los utilizan para planificar movimientos en el mundo real. El desafío es fundamentalmente diferente de un modelo de lenguaje. Para un robot, una predicción inexacta no sólo resultará en una palabra mal escrita, sino que también puede hacer que una pinza se acerque a un objeto o lo deje caer. Luego, el equipo de la Universidad de Maryland desarrolló una representación que no reproduce cada píxel de un vídeo futuro. En cambio, μ₀ describe las trayectorias espaciales de puntos seleccionados en manos, herramientas y objetos. Estas llamadas huellas de movimiento contienen información sobre dónde se mueve un objeto, cómo gira y dónde se produce el contacto. Los investigadores presentan el sistema en detalle en su informe original de la Universidad de Maryland y al mismo tiempo identifican las limitaciones restantes.
Cómo los robots obtienen movimientos de vídeos normales
La diferencia central en comparación con muchos enfoques anteriores es la separación de dos tareas de aprendizaje. En primer lugar, el modelo mundial debe comprender cómo se mueven los objetos relevantes en el espacio tridimensional durante una acción. Sólo entonces un llamado experto en acción traduce esta información en los comandos del motor de una máquina específica. Esto significa que el material de vídeo no tiene que estar vinculado a ángulos de articulación, posiciones de agarre o fuerzas de un robot específico. Para ello, el equipo también desarrolló TraceExtract. Este sistema busca puntos significativos en vídeos, los sigue espacialmente y conecta eventos de movimiento individuales con descripciones lingüísticas. Al mismo tiempo, debería distinguir si realmente se está moviendo un objeto o solo la cámara. Esto es importante porque, de lo contrario, un travelling podría parecer un movimiento de toda la escena. El siguiente artículo de investigación sobre μ₀ describe estas trazas de movimiento tridimensionales como una representación compacta de las interacciones.
Por qué el 91,7% importa en un brazo robótico real
Lo crucial es que los investigadores no solo probaron el enfoque en una simulación. Un brazo robótico equipado con una pinza de dos dedos tenía que colocar objetos en un fregadero, verter almendras y desplegar un paño. En estas tres tareas, la tasa media de éxito fue del 91,7%. Según la Universidad de Maryland, los dos sistemas de comparación fueron 20 y 11,7 puntos porcentuales más bajos, respectivamente. El resultado muestra que los patrones de movimiento aprendidos en vídeos pueden traducirse en acciones reales. Sin embargo, no es prueba de que este enfoque ya domine alguna actividad doméstica o industrial. El número proviene de tres tareas claramente definidas con un brazo robótico específico. El desarrollo previo de sistemas humanoides también muestra que es difícil pasar de la demostración a movimientos reales robustos. En forschung-und-wissen.de ya se ha descrito cómo el robot de la figura 01 aprende nuevas tareas mediante la observación.
En las simulaciones el panorama es mucho más contrastante.
La tasa de éxito real es particularmente interesante porque los resultados de la simulación no muestran un sistema consistentemente superior. En ocho tareas de cocina simuladas, μ₀ promedió 30,25%. Este valor fue mayor que un modelo de comparación con un 25,25%, pero menor que un segundo modelo con un 42%. Esto muestra una dificultad típica de la robótica moderna. Un método puede funcionar muy bien en una representación particular o en tareas individuales del mundo real y, sin embargo, no funcionar bien en una colección más grande de pruebas virtuales. Las simulaciones permiten muchas repeticiones y escenas muy diferentes, pero no representan completamente los contactos, la fricción, la deformación del material y los errores de las cámaras reales. Por el contrario, los experimentos físicos son más caros y, por tanto, suelen realizarse con menos tareas. Por tanto, ambos resultados son relevantes para la clasificación del nuevo sistema. μ₀ proporciona pruebas convincentes de una transferibilidad real, pero todavía no es un robot universal capaz de imitar de forma fiable las actividades de cualquier vídeo de Internet.
Por qué los vídeos son tan valiosos para la robótica
La ventaja potencial radica en la cantidad de datos disponibles. La gente ha grabado miles de millones de horas de vídeos de personas agarrando objetos, usando herramientas, procesando alimentos y operando máquinas. Las demostraciones específicas de robots son escasas en comparación porque deben grabarse para un hardware específico. Un modelo que extraiga patrones de movimiento generales de vídeos comunes podría reducir esta brecha. La adaptación al robot sigue siendo necesaria. μ₀ no decide directamente qué motor se controla ni con qué fuerza. Action Expert realiza esta traducción mediante demostraciones de robots adicionales. Pero la separación podría significar que gran parte del conocimiento puede reutilizarse si cambia el hardware. Esto es especialmente relevante porque los sistemas humanoides ahora están pasando del laboratorio a series de producción más grandes. Un ejemplo actual es la producción en masa de robots humanoides en China, donde los métodos de aprendizaje flexibles están adquiriendo cada vez más importancia.
Lo que aún le falta al modelo
Los investigadores citan varias limitaciones. Los errores en el seguimiento de puntos de imagen o descripciones generadas automáticamente pueden reflejarse directamente en los datos de entrenamiento. También hay un problema físico fundamental. El modelo describe principalmente la geometría y el movimiento, pero no tiene en cuenta explícitamente las fuerzas ni el sentido del tacto. Para muchas actividades, los caminos espaciales por sí solos no son suficientes. Por ejemplo, un robot debe distinguir entre sostener un vaso, un paño suave o una olla pesada. Trayectorias idénticas pueden requerir fuerzas de agarre completamente diferentes según el material. Aún no se ha estudiado el comportamiento del sistema en otros robots y en una gama más amplia de tareas. Esto sitúa a μ₀ entre un potente prototipo de investigación y un sistema de aprendizaje de aplicación general. El avance crucial no reside tanto en el hecho de que un robot pueda aprenderlo todo mirando, sino más bien en el hecho de que el conocimiento del movimiento está separado del control real de la máquina.
Esto podría hacer que el aprendizaje de robots sea mucho más escalable
Para la robótica, esta separación es un posible camino hacia conjuntos de datos de entrenamiento más grandes. En lugar de equipar cada nueva máquina desde cero con costosas demostraciones, un modelo general del mundo podría aprender primero, a partir de vídeos humanos y robóticos, cómo se mueven los objetos durante determinadas acciones. Posteriormente, sólo se necesitaría una cantidad menor de datos específicos del hardware para transferir el conocimiento del movimiento a un brazo o pinza específicos. Queda por demostrar si este enfoque permanece tan estable en cientos de tareas como en las tres pruebas reales. Sin embargo, el estudio proporciona evidencia técnica concreta de esto. Los vídeos no se convierten simplemente en obras de arte para robots. Pueden convertirse en una fuente de información sobre el movimiento espacial a partir de la cual las máquinas aprenden qué partes de una escena necesitan moverse y hacia dónde. Ésta es precisamente la diferencia entre una inteligencia artificial que reconoce una acción y un sistema que puede realizarla en el mundo físico.
Construido con el apoyo de inteligencia artificial.
 La mayoría de los viajes de camiones a Alemania pueden realizarse eléctricamente
 El recubrimiento hace que los módulos solares en los desiertos
 La casa de madera más alta del mundo está en construcción en los Estados Unidos.
 SUVS & CO. – El capó se está volviendo más alto y, por lo tanto, pone en peligro a los peatones
